
Transformer 的几何角度梳理
Transformer 的几何角度梳理
Transformer 里那些矩阵乘法,写成公式只是符号堆叠,摊开成向量的点积和投影就好理解了。这篇按计算顺序把 Self-Attention 和 FFN 走一遍,重点看每一步在几何上做了什么。
Self-Attention 的矩阵运算
一、矩阵乘法按行拆开看
设 $A \in \mathbb{R}^{m \times n}$,把它按行分块:
其中每个 $\mathbf{a}_i^{\top}$ 是 $1 \times n$ 的行向量。再设 $B \in \mathbb{R}^{n \times p}$,则
也就是说,$AB$ 的第 $i$ 行等于 $A$ 的第 $i$ 行(行向量)右乘 $B$,得到 $1 \times p$ 的行向量,再把这些行摞起来。这里做的是按行拆分,不是相加。
二、输入矩阵乘权重矩阵
设输入 $X \in \mathbb{R}^{n \times d}$,每一行是一个 token 的向量,$n$ 是 token 数,$d$ 是隐藏维度。三个投影矩阵的维度分别是:
于是
按上一节的结论,$XW_Q$ 的第 $i$ 行就是 $\mathbf{x}_i^{\top}$ 乘上 $W_Q$。几何上,这就是把每个 token 向量都做同一个线性变换,映射到 Q、K、V 各自所在的子空间。
三、Q 乘 K 的转置
$S \in \mathbb{R}^{n \times n}$,第 $(i,j)$ 个元素是第 $i$ 个 token 的 query 与第 $j$ 个 token 的 key 的点积。$QK^{\top}$ 一次矩阵乘法就给出所有 token 两两之间的分数,不必写双重循环,这就是并行计算点积的含义。
四、完整的 attention
其中除以 $\sqrt{d_k}$ 是为了避免点积随维度增大而方差变大、softmax 进入饱和区;softmax 沿每一行做,把分数变成权重;最后用权重对 $V$ 的行做加权求和,得到每个位置的新表示。
FFN
FFN 的两层都是矩阵乘法,只是方向相反。
升维那一层的权重矩阵,每一列都是一个基底向量。输入 token 乘上去,等于拿这个 token 跟每一个基底向量做点积,结果就是它在这组基底下的坐标。有多少个基底,输出就有多少维。
降维那一层同理,只是基底的数量少一些。
两层之间的 ReLU(或 GELU)逐元素作用,把线性映射掰弯。少了这一步,升维和降维会合成一个矩阵,整个模块退化成一次线性变换,宽度堆得再大也没用。
所以升维的作用可以概括成一句话:输入输出维度不变,中间的折叠空间变宽了。
FFN 的几何拓扑
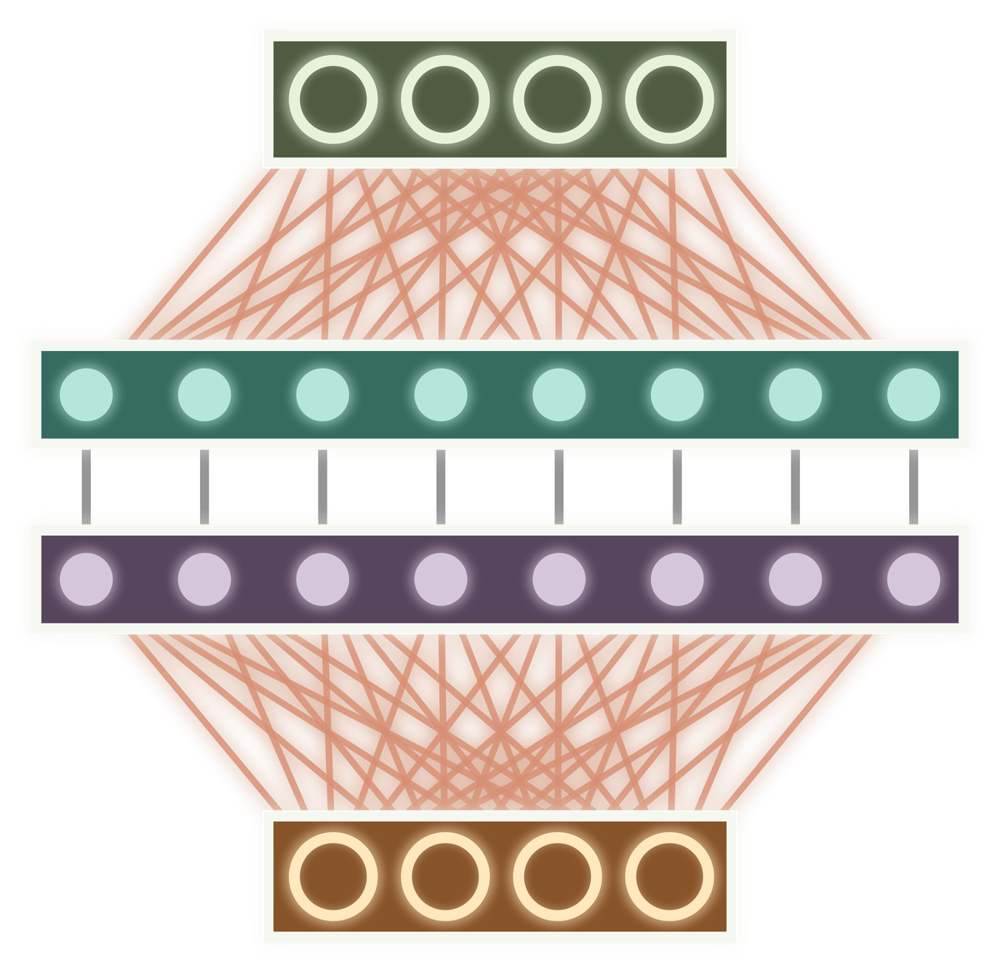
图里每个圆圈是 token 的一个维度分量,线是计算过程。上下两侧的连线带权重和 bias,中间那一段是逐元素的非线性函数。